AI 编程共享平台
这是一套面向缺少编程经验的医生的科研工作台。我负责平台设计搭建,将账号、科研环境、API 分发与用量管理组织在一起,并参与科研 Skill 的测试、部署和脚本化改造。平台已部署并有少量试用;这段实践重点是把共享工具接到具体科研任务,再用人工结果检查输出。
从医生的科研与编程难题出发
在百奥码克参与这项工作时,我从微信群里的交流了解到医生已有的科研需求与编程难题。医生手里有所在医院或科室的数据,希望应用相应的研究方法完成处理、建模与分析,但主业是临床,通常没有足够的时间与编程经验来实现这些步骤。老板长期从事医学科研,也与医生社群保持交流,我们围绕这些需求讨论过可以怎样提供帮助。
在我们当时接触到的使用方式里,AI 主要以网页聊天的形式出现。医生可以向它讨论思路、询问代码,但要围绕自己的数据连续完成实际分析,仍缺少一个好用的方案。
后来了解到 Claude Code,我们发现这种直接面向本地文件的 AI 交互方式很有价值:把编程需求说明白后,它可以围绕实际的数据与代码开展工作,完成一些处理、分析和自动化操作。这让我们开始尝试把它放进服务器上的科研工作环境,医生上传自己的数据,就能在同一处使用方法指导与编程能力。
将科研方法、算力与 Token 打包提供
平台早期的产品逻辑,是把完成科研任务需要的方法、运行环境和模型用量一起提供。我们设想将一套科研解决方案、服务器算力与调用模型的 Token 捆绑售卖,让医生获得可以围绕自己数据开展工作的整套条件。
其中,方法部分最早以解决方案 Markdown 的形式承载,整理处理步骤、规则与整体流程;后来再尝试用 Skill 来组织和分发。沿着这段演进看,捆绑售卖的逻辑一直是“方法包+算力+Token”,改变的是方法包怎样被 AI 理解和执行。这个商业设想也影响了平台实现:需要准备用户环境、提供方法材料,并管理模型调用额度与用量。
一键开通工作环境
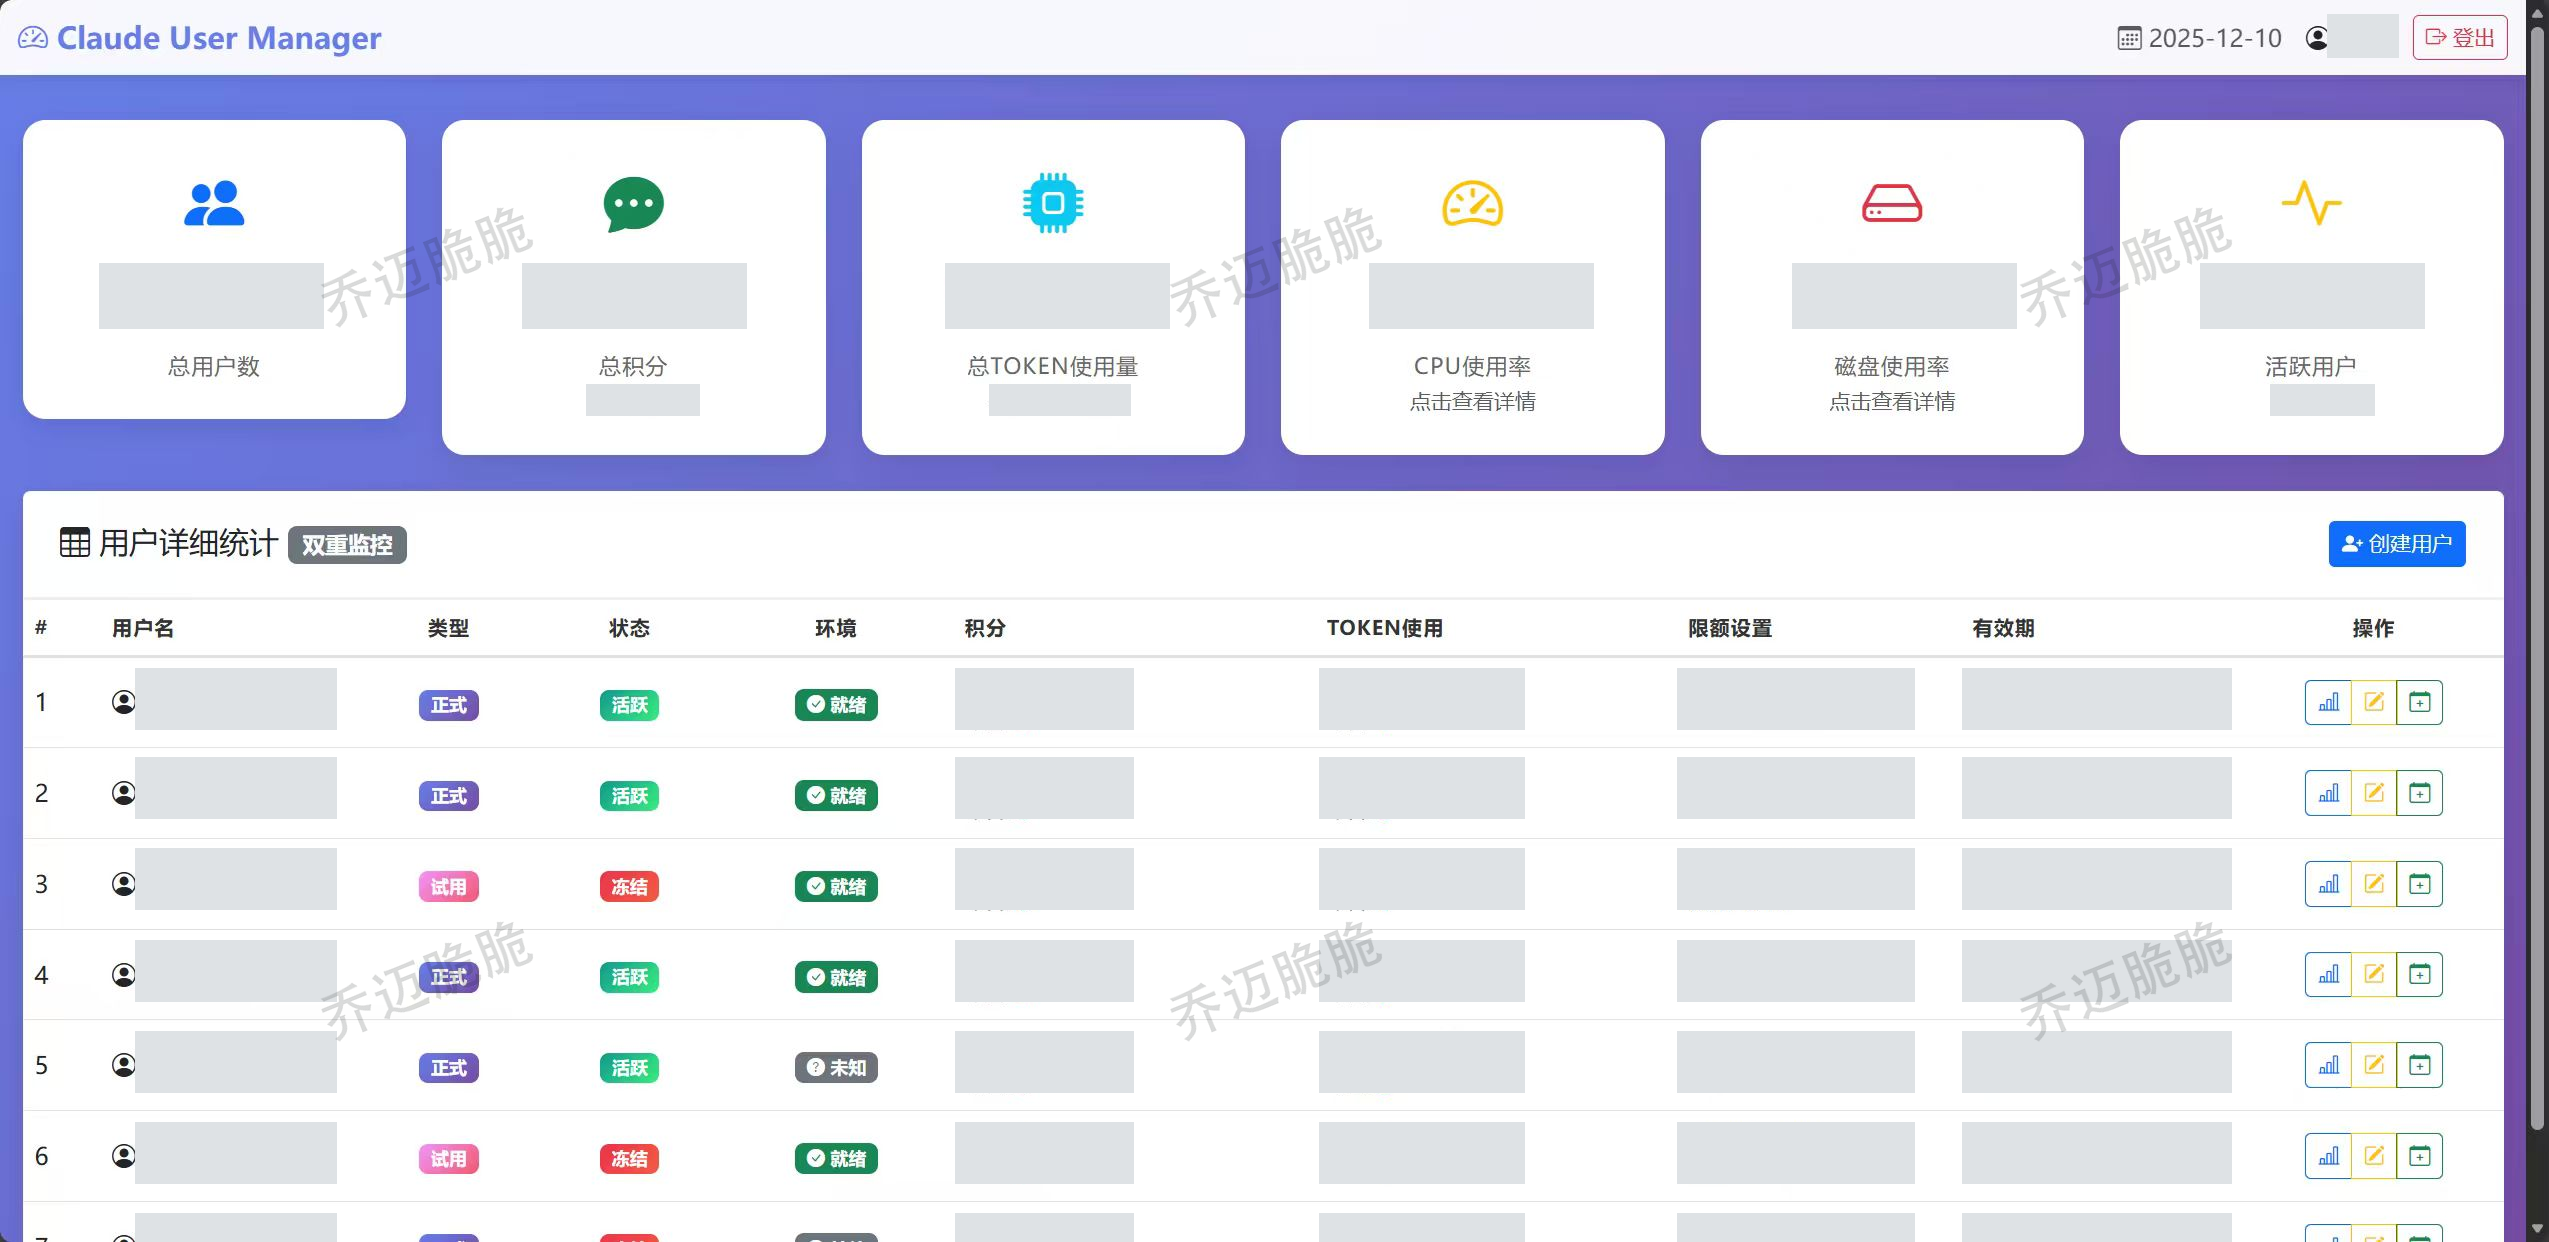
管理员在后台创建用户时,平台会一并建立账号和个人目录,配置 Claude Code 的 API 接入,并在后台为用户准备各自的 Python、R 环境。管理员可以查看环境准备状态,再将账号交给用户使用。
我设计并搭建了这套云端科研工作台,负责需求整理、产品拆解,将账号开通、环境准备和 API 接入组织在同一套流程里。
为了让多人共享使用 AI 服务,我搭建了 API 分发、Token 额度分配与用量计量功能。账号、环境和 API 配置放在同一个开通流程里,减少了逐项手工准备的操作;后续也能在后台查看用户状态、调整额度和了解使用情况。
选用 JupyterHub,是因为课程已有 Notebook 课件、作业和建模代码,可以延续已有使用方式。用量管理根据接口返回的 Token 和成功调用次数按用户记录消耗,提供分时统计、限额和有效期管理,便于查看和管理共享资源。
进入自己的科研工作区
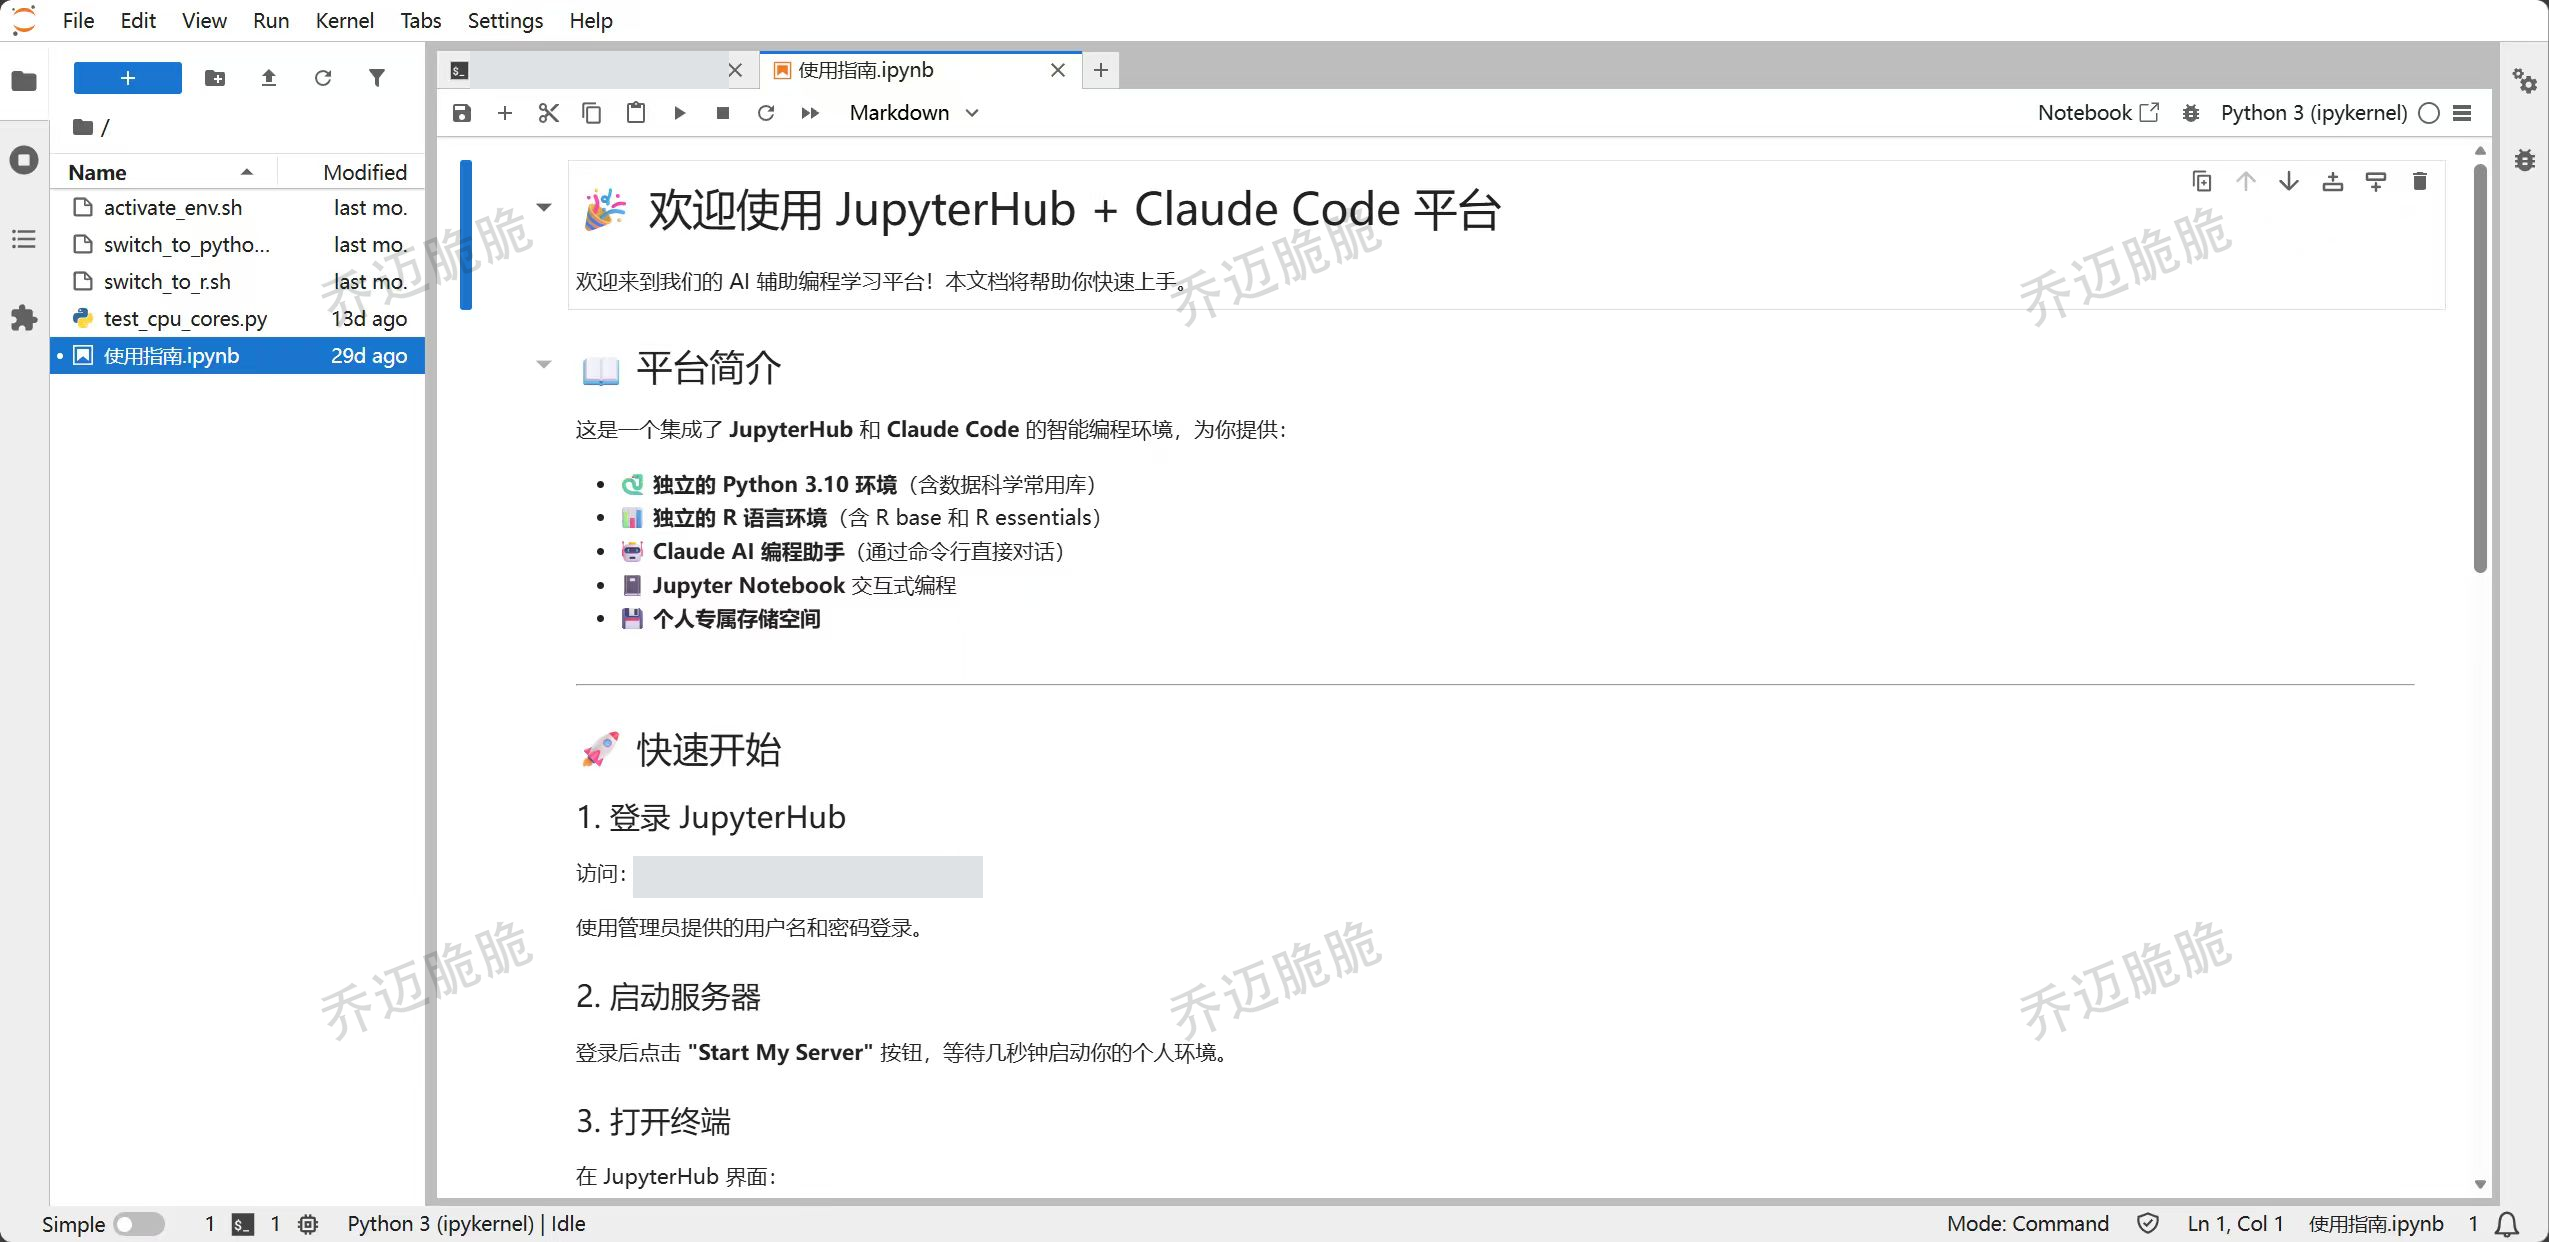
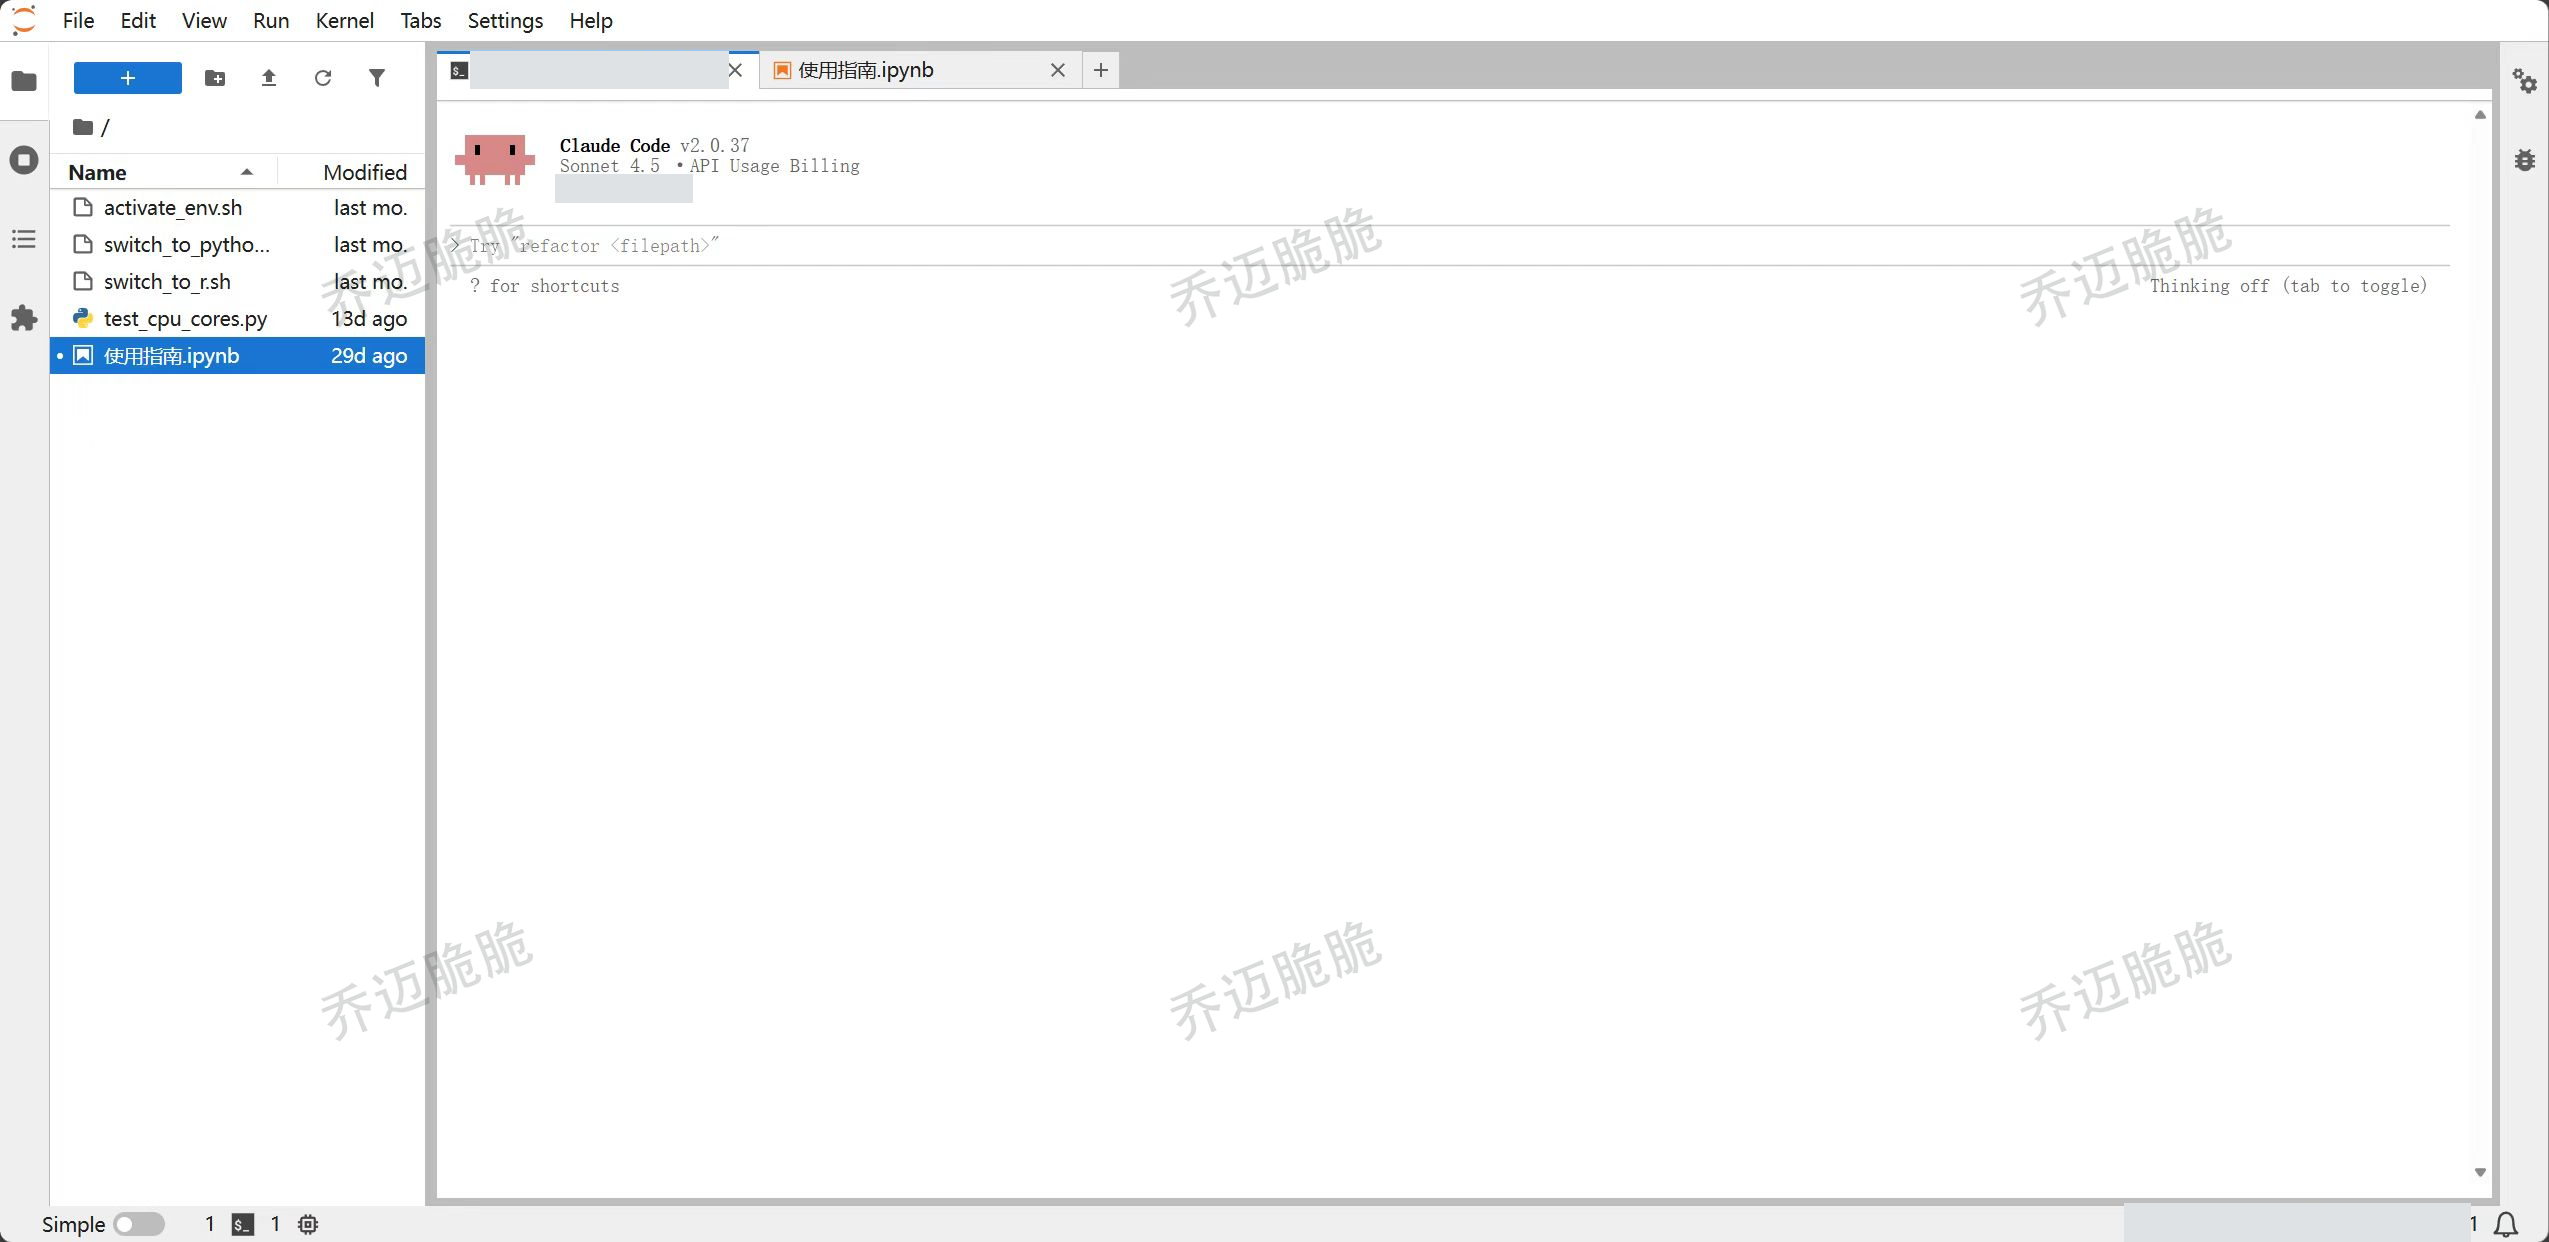
用户登录 JupyterHub 后,可以在同一工作区里查看使用指南、管理个人文件、运行 Notebook,并通过终端使用 Claude Code。Python 和 R 环境也随账号准备好,让用户把精力放回数据和分析任务,而不必从本地安装配置开始。
使用指南与 Claude Code
长任务暴露了模型的能力边界
我们先将已有的一篇研究工作的处理过程拆解出来,整理成 Markdown 说明文档,把数据处理、建模和分析的方法交给 AI,尝试让它结合用户的数据完成整段任务。
实际尝试暴露了两种任务之间的差距:模型能完成较明确的局部编程需求,但当时使用的模型,还不能稳定地依据这样一份长文档,连续完成包含多个阶段的科研任务。任务推进到中后期,会出现输出漂移和幻觉,完整过程的可靠性不足。团队因此暂停过一段时间。
这次受阻影响了我们对产品能力的判断。把流程写完整,并不意味着当时的模型就能稳定执行完整流程;工作环境准备好了,也仍然需要验证任务到底能走到哪一步。
- 围绕真实科研任务准备环境与方法
- 用解决方案 Markdown 承载处理流程
- 长任务中后期输出漂移,暂停尝试
- 借助 Skill 重新探索分阶段执行
用 Skill 重新组织分阶段的工作
后来接触到 Skill 的渐进式披露方式,我们觉得它与科研任务分阶段推进的特点比较契合,于是重新尝试,将原来放在解决方案 Markdown 里的方法改为按阶段组织。首个 Skill 聚焦临床表格数据的预测建模,把阶段说明、可复用脚本和需要询问用户的节点组织在一起。
首个应用 clinical-ml-model 让医生提供数据、明确要预测的结果,再沿着数据检查、特征筛选、模型训练和评估逐步推进。
其中,对话负责澄清目标与衔接步骤,脚本负责重复计算。比如特征筛选被单独封装,约定调用同一份脚本并保存入选字段;训练与评估也有对应入口。流程仍需要 Agent 按约定组织执行,关键选择交给用户确认。
Skill 在平台中央目录统一注册,再分发到用户环境,由 Claude Code 发现和使用。这样,科研 SOP 可以随工作环境一起交到用户手里,减少重复配置。
科研方法与分析流程来自负责人既有的科研和带教经验。我负责平台设计搭建,参与 Skill 测试、服务器部署,并参与将可复用计算步骤整理成脚本;科研方法与算法实现按团队协作推进。
初期 Skill 的说明和代码要求较散,长任务后期仍出现调用不稳定。我参与梳理特征筛选等常见步骤,借助 AI 提取代码、整理为脚本并整合进 Skill,减少重复生成代码的上下文负担。这个改造旨在提高执行一致性,尚没有前后对照数据证明具体的稳定率或 Token 改善。
从一份数据开始
流程先查看字段类型、缺失情况与目标变量,询问哪些列需要排除,再确认训练与测试的划分比例、交叉验证折数等配置。这样,医生不必从一段空白代码开始,也有机会在计算前确认这次分析的问题。
进入特征筛选后,可以选择单因素分析、L1 正则化筛选(流程中称为 LASSO)、两者串联,或者保留全部字段。筛选脚本会留下分析表和入选特征列表,供后续建模使用。
训练环节提供逻辑回归、随机森林、XGBoost 等算法入口,先在训练集内做交叉验证,再用训练集重新拟合模型,最后在留出的测试集上评估。多模型比较由 Agent 组织多次调用,筛选结果和训练配置也需要在步骤之间保持一致。
评估不只返回一个分数。脚本计算 AUC、敏感性、特异性等指标,并绘制 ROC、校准曲线和决策曲线;另有 SHAP 解释入口。它们分别帮助查看区分能力、预测概率与实际结果的关系,以及特征对预测的影响,作为进一步分析的材料。
让结果可以继续使用
输出也被纳入了流程:特征筛选结果保存为表格与字段清单,训练结果保存为指标文件和图表。源码中还包含一个按项目管理模型的 Web 界面,可以组织模型版本、保存模型与标准化器,并为新数据生成可下载的预测结果。
在主流程之后,Skill 还设计了外部验证、部署预测页面、辅助整理 Methods 与 Results 草稿等可选分支,由用户决定是否继续。这些步骤并非都封装在同一脚本里,仍需要 Agent 接续任务、补充资料和人工复核。
这个设计想解决的不只是“跑出一次结果”,还包括计算之后如何查看、比较和继续使用。它服务的是科研建模与分析,模型输出仍需研究者结合数据和研究设计判断,不直接用于临床诊疗决策。
用同一份数据检查任务输出
团队基于真实临床数据运行科研 Skill,约 2 小时完成数据处理、模型训练与评测出图。此前负责人带学员完成同类任务,通常需要 5–7 天;这是历史带教经验,不能与单次运行时间换算成同条件的效率提升百分比。
除了观察耗时,我们还使用同一份临床数据,将 Skill 输出与此前人工处理、建模的结果对比,检查格式是否正常、是否存在明显异常值,以及结果是否接近。试用中未发现明显格式或数值异常,输出与人工结果基本接近,主要处理、训练和出图步骤由流程自动衔接。
复核者反馈相关产出可用于论文撰写。这是当次定性检查的结论;具体指标差异、重复次数和人工干预次数没有完整留存,检查也没有覆盖全部统计方法与计算分支。
这次经验让我把任务跑完与结果可以继续使用分开检查。后续若继续推进,需要统一各步骤的数据划分与配置,保留输入、过程和产物,再扩大回归范围。整体流程的效率反馈不能单独归因于脚本化改造。
平台停下后,探索延续到课程
平台已经完成部署与试用,但方法、算力与 Token 的捆绑售卖还需要持续的服务接入与运行支持。后续独立推进受到 AI 服务接入限制、服务器成本和老板精力等条件影响。老板后来转向 AI 辅助科研课程,将围绕临床分析流程构建 Skill 的方向延续到教学中,让医生学习结合各自医院的私有数据建立分析流程。
共享平台后来没有继续独立推进,围绕科研任务整理和构建 Skill 的探索,则被用于课程方向。我主要参与前期平台搭建与流程探索,课程由负责人后续推进。
回看这段工作,我更清楚了局部代码能力和完整任务能力之间的距离。真实需求从一开始就存在,产品方案却需要跟着实践中看到的能力边界调整;工具与模型发生变化时,再判断是否值得重新尝试。