医学公开数据集平台
医学公开数据集分散在不同网站,获取路径也不统一。围绕科研与课程使用需求,老板提出搭建平台的初始想法,我负责平台搭建、资源收集与信息整理,两周完成 MVP,汇总 400+ 公开数据集索引,累计获得 200+ 实际注册用户。首版聚焦检索与共享,取舍依据是需求、数据来源与开发投入是否匹配。
数据分散带来的阻力
医学公开数据集散落在不同网站,下载速度、文件格式和说明方式各不相同。科研与课程用户往往要先跨多个来源搜索,再判断器官、模态和任务是否匹配;产品需要同时解决“找到什么”和“怎样获得”,而不只是聚合链接。
先检查功能成立的条件
最初讨论的范围包括在线预览和在线标注。这些功能实现较复杂,超出了当时的时间安排;进一步了解后,我们发现,当时讨论的场景还需要医生或医院提供私有数据,而团队缺少对应数据来源,也没有明确的标注需求来源。
我据此将第一版收敛到公开数据集检索与共享,把时间用于已有资源能支撑的查找和获取任务。判断首版范围时,需要一起检查需求是否明确、数据是否可获得、开发投入能否承担。
这是当时具体场景的取舍。若后续扩展预览与标注,应先明确使用者、数据条件和任务,再决定产品范围。
- 整理分散的官方数据来源
- 把网页信息统一为标准元数据
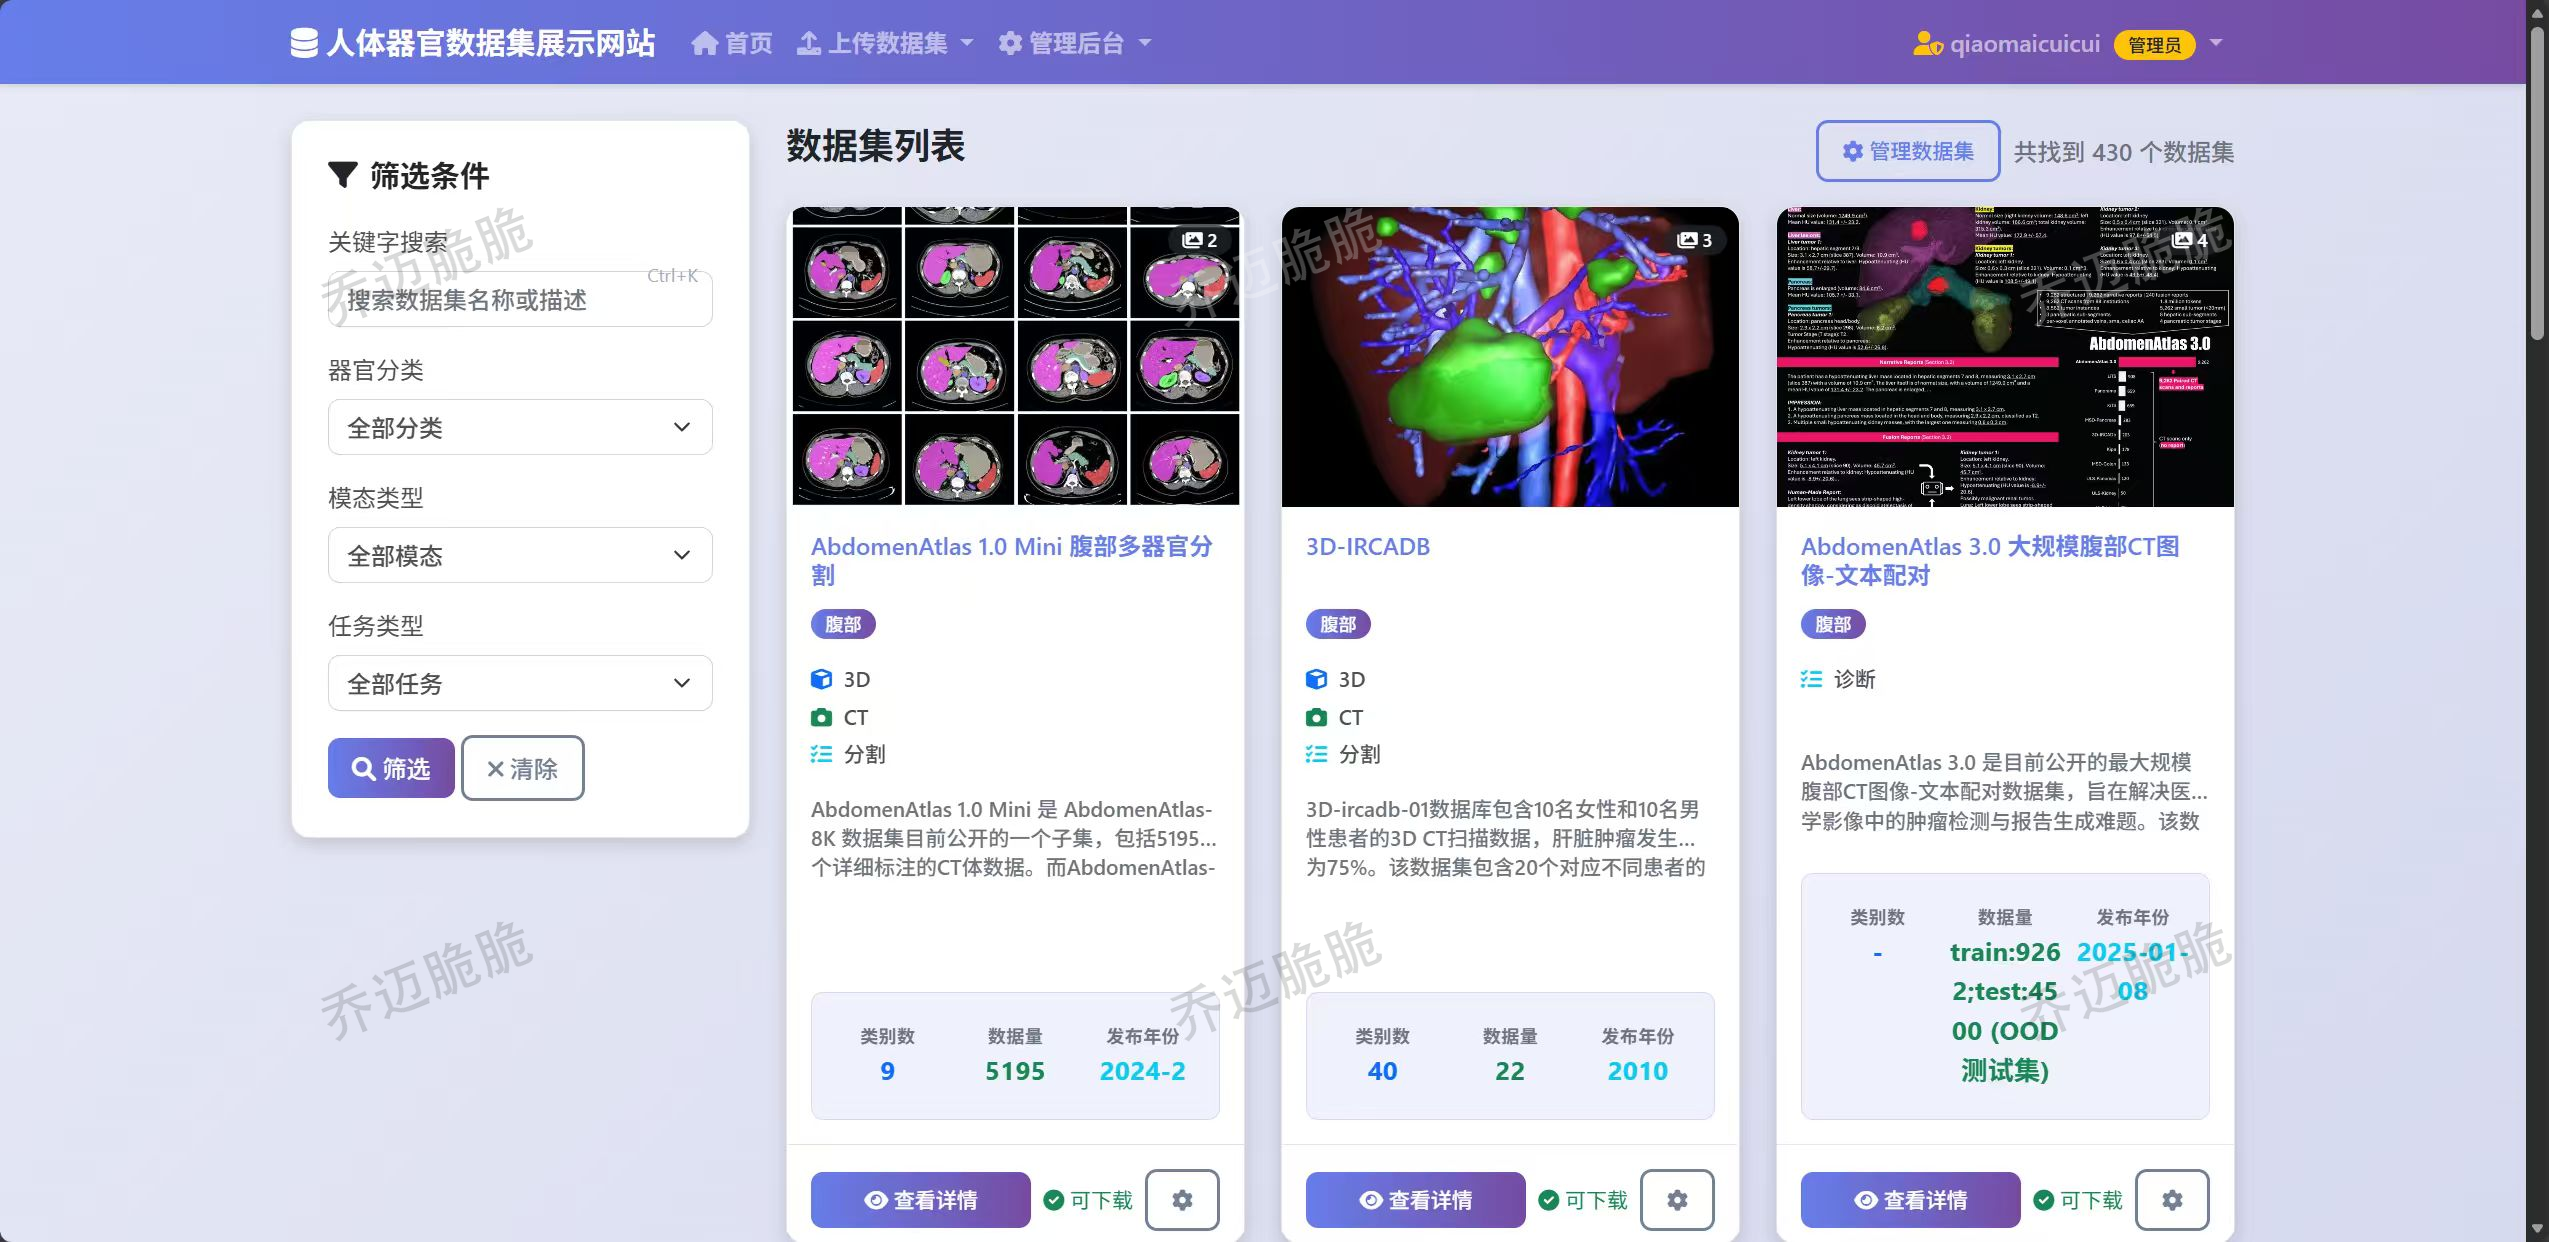
- 按器官、模态与任务建立筛选
- 连接官方来源展示与服务交付
让 AI 整理的信息有人工参照
我负责资源收集与信息整理,使用 LLM 将网页说明转换为结构化介绍与分类,按器官/科室、任务类型和数据模态组织索引,让用户可以从集中入口筛选相关资源。
对整理后的信息,我结合已爬取的数据集图片,以及公开的数据集收录与分类表单,人工快速核对。AI 承担重复整理工作,图片和分类资料为人工判断提供参照;当时没有形成量化准确率或逐字段验收记录。
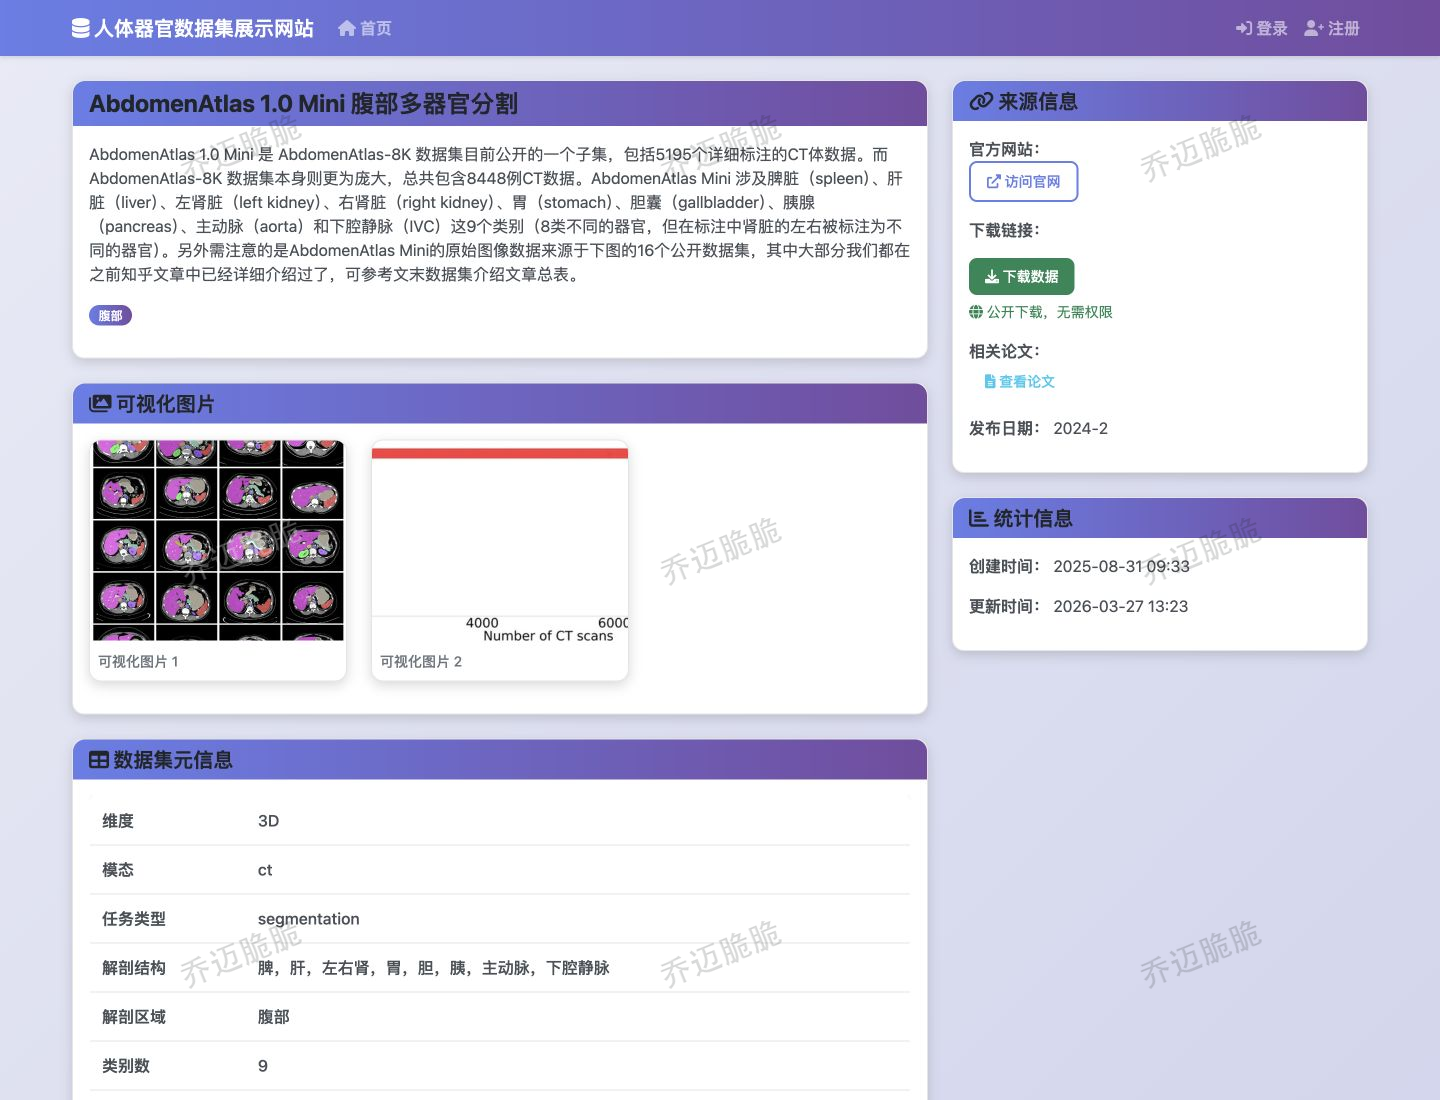
进入详情,判断是否适用
找到一个数据集之后,还要判断它能不能用于自己的任务。详情页把简介和图示放在前面,再列出模态、任务类型、解剖结构、类别数、数据量和文件格式;官网、论文与获取入口单独放在右侧。以 AbdomenAtlas 为例,用户可以先看它覆盖哪些器官、提供怎样的标注,再决定是否继续获取。
获取入口同时提供官方下载链接,以及团队提前下载、收集后整理的百度网盘资源链接。用户可以在了解数据内容后选择获取路径,平台负责把分散的说明、来源和资源入口集中到同一处。
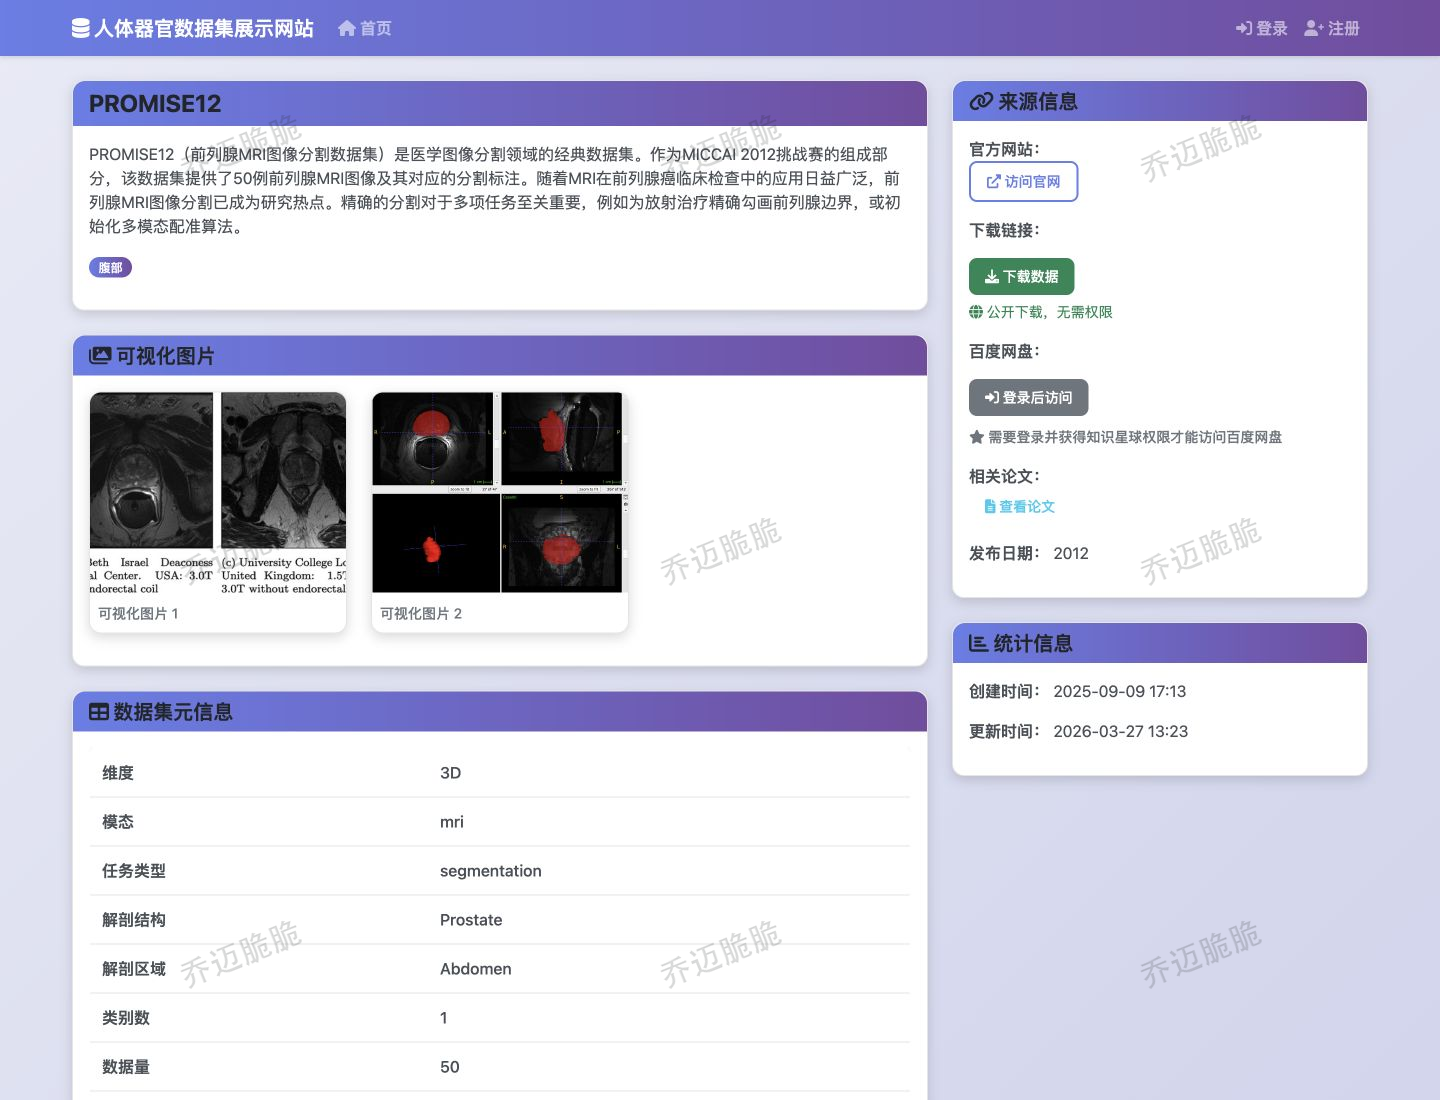
同一套信息结构
从腹部 CT 换到前列腺 MRI,用户不需要重新适应另一套页面。PROMISE12 仍然按简介、图示、元信息和来源展开,便于在熟悉的位置查找信息。页面下方还保留文件结构、图像尺寸统计和引用,供准备实际使用数据的人继续查看。
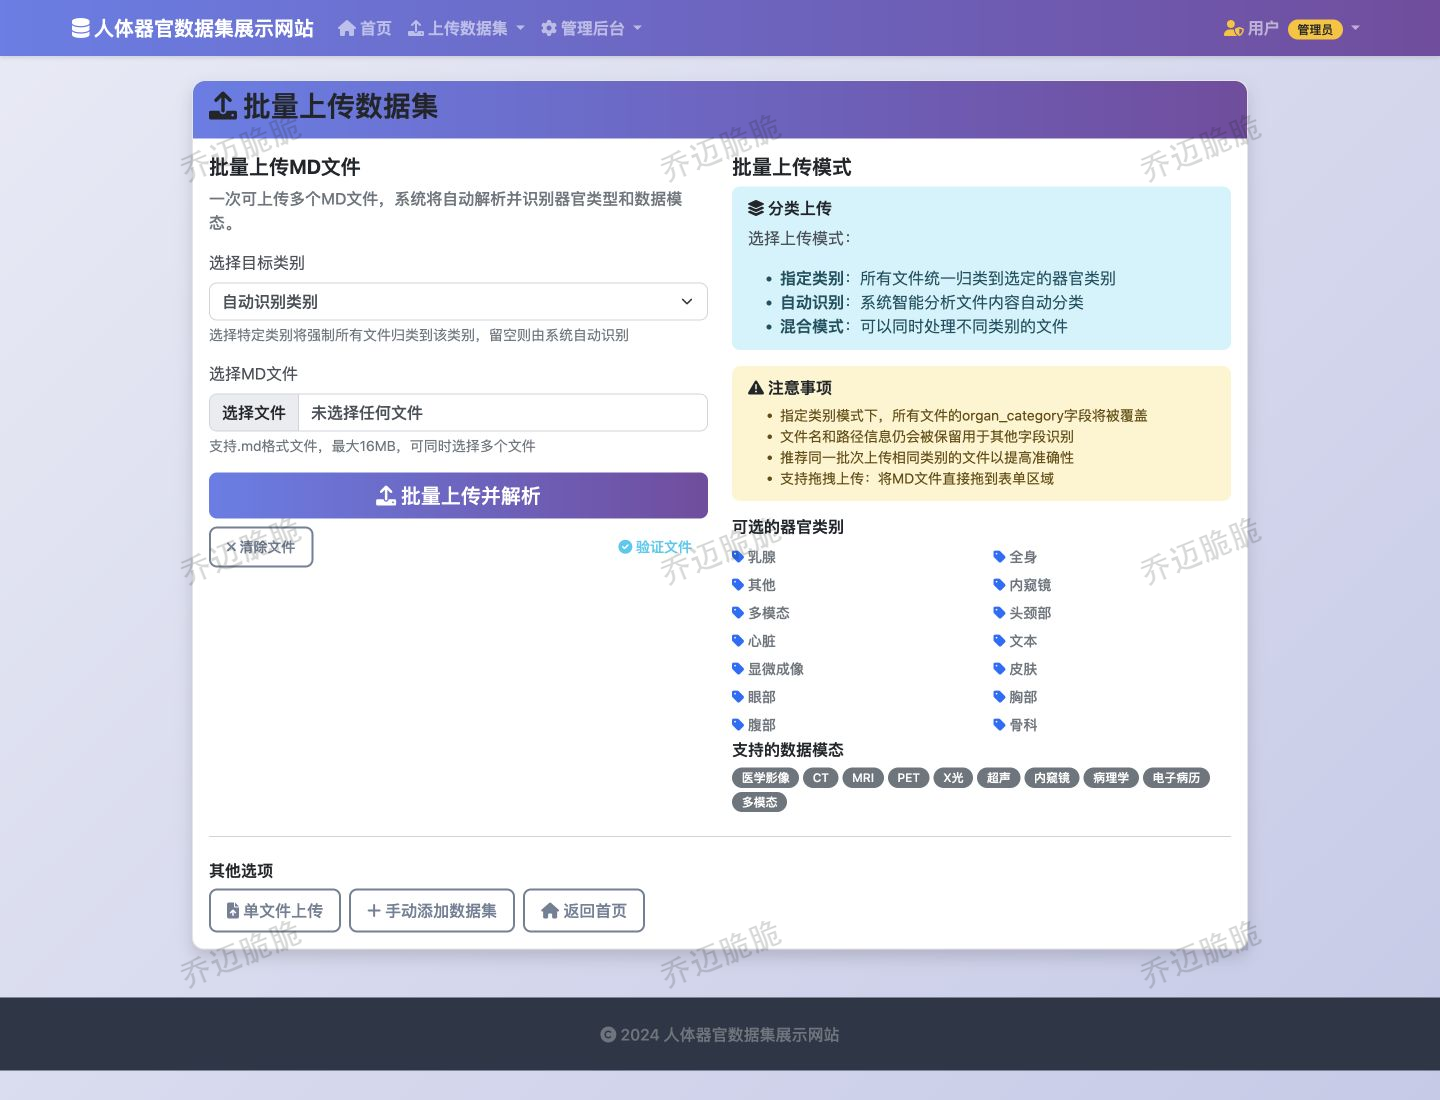
让整理好的资料便于维护
展示之外,我也需要考虑资料怎样持续进入网站。整理好的说明可以按 Markdown 文件批量导入,由程序解析字段并归类;页面同时保留手动指定类别的入口,不必每条都从空白表单填起。这里的导入使用字段解析与分类规则,承接的是前面已经整理好的资料。
回看这个 MVP
平台两周内完成 MVP,汇总 400+ 公开数据集,累计获得 200+ 实际注册用户。第一版完成了集中检索、统一说明和获取入口的组织,让用户可以先判断数据是否适合自己的任务,再通过网盘或官方链接继续获取。
200+ 注册说明平台获得了初步触达,但注册之后是否找到所需数据、是否持续使用,尚缺少记录。后续若继续迭代,我会围绕查找任务是否完成来判断效果,再决定是否扩展功能。
平台目前已不可访问,这里保留当时的页面与产品思路。对我而言,关键取舍是在动手开发前检查功能赖以成立的条件,并让平台建设与内容供给在同一个 MVP 范围内完成。