PromptLab
PromptLab 是我围绕 Linxi 生图调优搭建的提示词实验台。每次修改需要回答:原来的问题有没有改善,新的输入上是否仍然适用,以及下一位同事能否复查。我定义测试样本、评审维度和版本边界,借助 AI 编程实现工具,并通过仓库和说明交接。
调优记录难以追溯
原来的调优需要反复导入图片、改提示词、保存结果并靠人记住差异。样本、模型或版本一变,就很难判断效果来自哪次修改,也很难把经验交给下一位使用者。
让每次实验可比较
我定义实验需要保留的对象与边界,再借助 AI 编程完成工具实现。正式 Prompt 和自定义实验分开;每次运行记录模型与 Prompt 版本,人工确认后才生成正式差异。
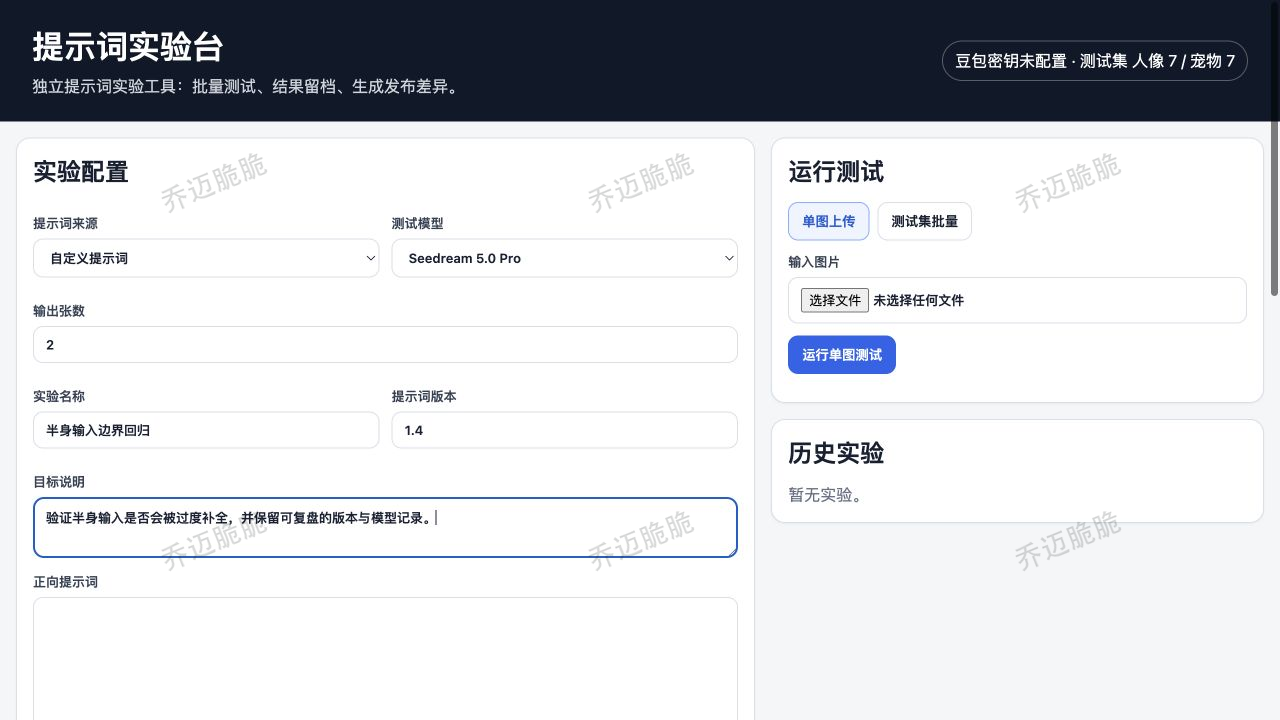
- 固定人物与宠物测试输入
- 记录模型、版本与生成结果
- 复盘 Bad Case 与修改影响
- 人工确认后生成正式差异
让比较结果进入下一轮修改
我将主体相似度放在首位,再看打印友好度、风格命中度和轮廓清晰度。固定 13 张人物/宠物输入用于版本回归,测试同学人工评分,团队结合具体图片与失败案例讨论。
PromptLab 保留每次运行的输入、结果和 Prompt,帮助我们追溯改了什么。判断和修改由人完成:从输出中找出具体问题,提出原因假设,调整生成方案,再用固定集与新增图片检查;工具不自动评分,也不替代效果判断。
一次主体补全问题
半身或头部照片被 AI 补出多余身体时,我先把问题拆成可以尝试的假设:是不是主体靠近图像边缘,让模型认为形象还没有结束?增加留白和提取主体都不够稳定,我随后提出加入底座,用明确的结构限制继续延展。
我们对原有 13 张固定测试图片做了回归,又加入几张此前未测过的半身、头部图片;这些输出中未再出现过度补全。固定样本用于比较修改前后,新图片则用于观察方案能否处理原测试集以外的输入。
这次实验的价值包括得到一个可用方案,也包括保留从假设、失败尝试到验证结果的过程。后续生成质量仍由人判断,PromptLab 承接的是测试记录与版本比较,不能把一次回归结果扩大成所有图片的成功率。
交接与后续思考
工具已通过 GitHub 仓库和简单说明交接,支持固定样本测试、结果留档、版本记录和发布差异。生成质量仍由人判断,尚未建立统一的通过阈值或自动评分。对我来说,这一阶段的价值是先让变化可追溯,再逐步形成稳定的质量标准。